Was LLM-Trainingsdaten überhaupt sind
LLMs wie ChatGPT, Claude oder Gemini haben ihr Fitness-Wissen aus Text. Das ist ein wichtiger Unterschied zu einem Trainer, der Pläne selbst ausprobiert hat.
Beim Vortraining liest das Modell riesige Mengen Text und lernt Muster darin: was auf was folgt, welche Begriffe zusammengehören, wie Texte aufgebaut sind. Fitness-Wissen entsteht dabei durch das Lesen von Texten über Training, ohne eigene Trainingserfahrung.
Das LLM hat also tausende Artikel über progressive Belastungssteigerung gelesen, hunderte Studien zur Periodisierung und dutzende Bücher über Krafttraining. Daraus hat es sich ein Bild von „Training“ gebaut, ohne je eine Hantel angefasst zu haben. Das Modell weiß, was in Texten steht. Was in keinem Text steht, weiß es nicht.
Das Modell lernt nicht während des Gesprächs
Während du mit ChatGPT chattest, lernt das Modell nicht dazu. Korrigierst du heute eine schlechte Antwort, weiß es das morgen nicht automatisch besser. Zwei Einschränkungen gibt es aber: Je nach Einstellung können deine Chats ins Training späterer Modellversionen einfließen, und Memory-Funktionen merken sich Dinge über dich. Das Datum, bis zu dem das Wissen reicht, heißt Knowledge Cutoff. Das ist wie das Erscheinungsdatum eines Buchs: Was danach passiert ist, steht nicht drin.
Woher das Fitness-Wissen kommt
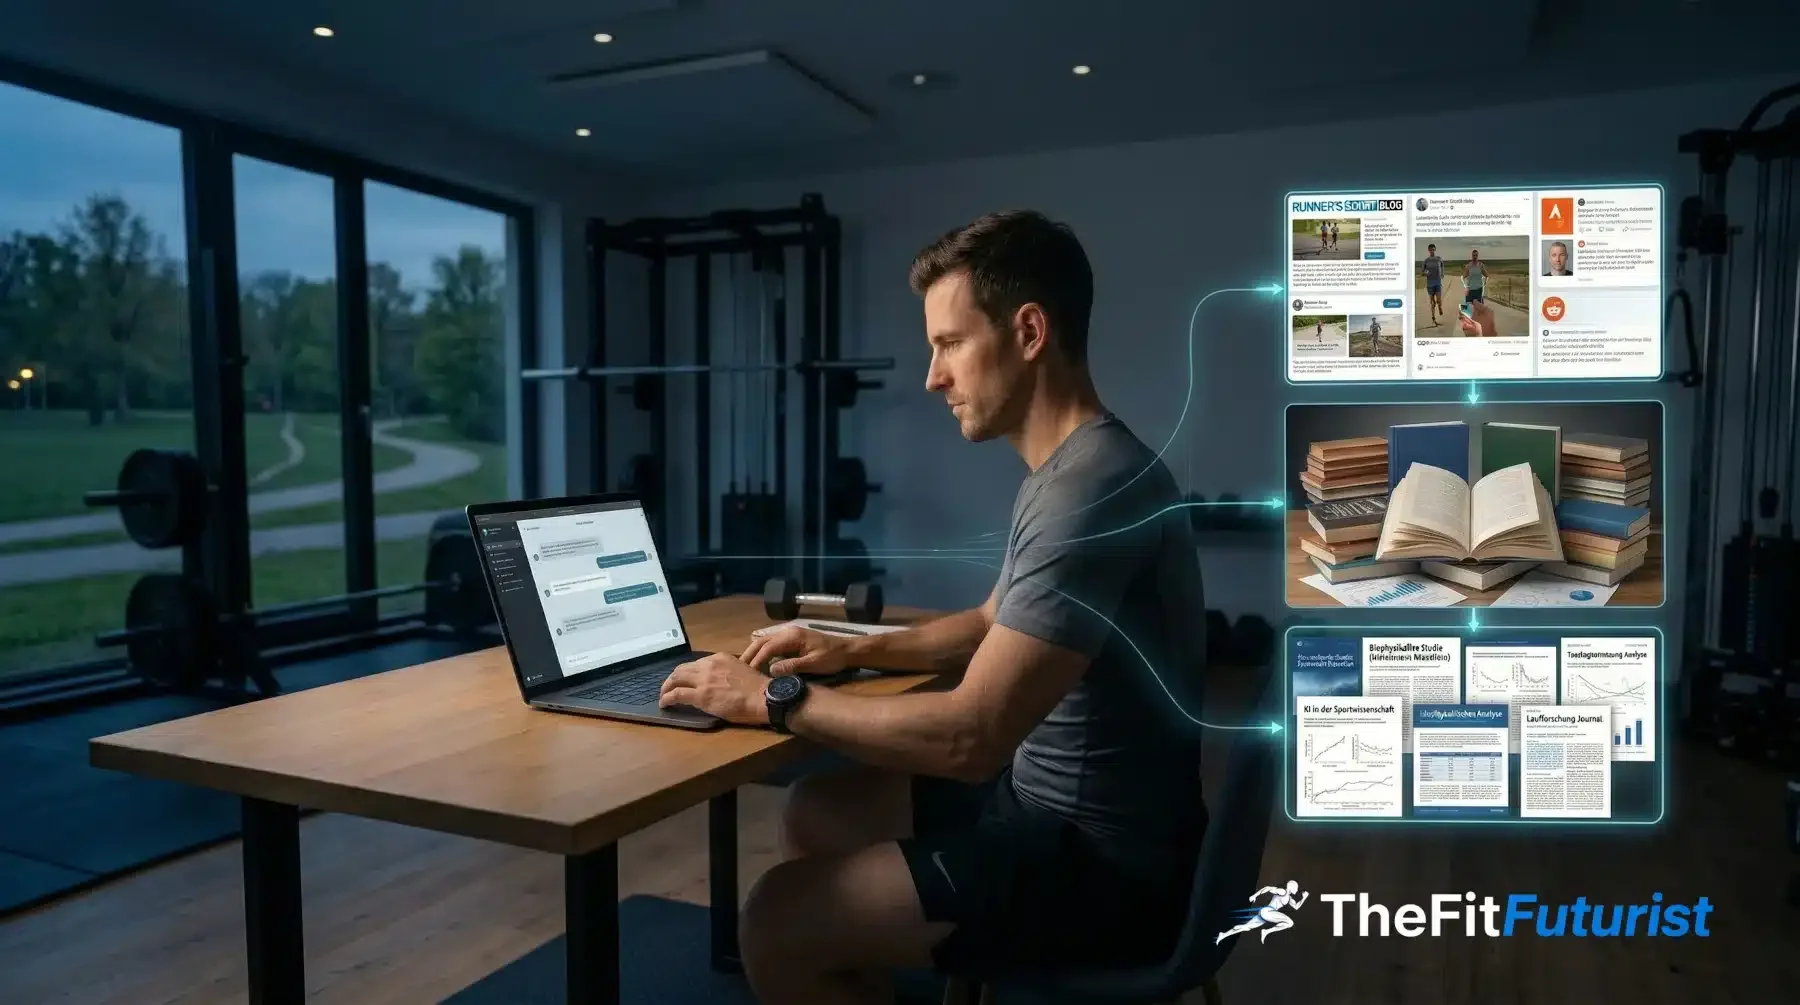
Die drei Hauptquellen für das Trainingswissen eines LLMs sind Webseiten und Blogs, wissenschaftliche Studien und Bücher. Alle drei haben eigene Stärken und eigene Schieflagen.
Webseiten und Blogs
Webseiten und Blogs machen mengenmäßig den größten Teil der Trainingsdaten aus. Wie groß der Anteil genau ist, hängt vom Datensatz ab, meist liegt er deutlich über der Hälfte. Der bekannteste Datensatz heißt Common Crawl: eine automatische Sammlung von Milliarden Webseiten, die regelmäßig aktualisiert wird. Fitness-Blogs, Foren und Ratgeberseiten landen alle darin. Themen, über die im Web viel geschrieben wird, kennt ein LLM deshalb gut. Nischenmethoden oder neue sportwissenschaftliche Ansätze kaum.
Das eigentliche Problem ist die Struktur dahinter. Ich kenne diese Branche und weiß, wie Inhalte dort oft entstehen. Ob jemand KI als Schreibwerkzeug nutzt, ist dabei zweitrangig. Schwierig wird es, wenn Leute über Themen schreiben, die sie nicht beherrschen. Trainingsartikel entstehen dann, indem man schaut, was die Konkurrenz schreibt, und es leicht umformuliert. Das Ergebnis: hunderte Artikel mit derselben Kernaussage, die sich gegenseitig bestätigen, ob sie fachlich stimmt oder nicht.
Für ein LLM sieht das wie Einigkeit aus. Das Modell kann nicht unterscheiden, ob ein Text von jemandem mit 15 Jahren Coaching-Erfahrung stammt oder von jemandem, der drei Stunden gegoogelt hat. Es sieht nur: Diese Aussage taucht auf vielen, oft verlinkten Seiten auf. Beliebt heißt aber nicht richtig, und diesen Unterschied kann ein LLM beim Training nicht zuverlässig erkennen.
Wissenschaftliche Studien
Wissenschaftliche Texte aus Quellen wie PubMed, arXiv oder anderen Fachdatenbanken machen je nach Datensatz einen deutlich kleineren Teil aus, grob zwischen 2 und 25 %. Sportwissenschaft ist davon nur ein kleiner Bruchteil. Meine Überschlagsrechnung: Am Gesamtdatensatz dürfte sie unter einem Prozent liegen, eine exakte Zahl gibt es nicht. Das liegt schlicht an den Mengen, denn Medizin, Physik und Informatik veröffentlichen um ein Vielfaches mehr.
Dazu kommt eine Schieflage, die sich durch die ganze Literatur zieht: Sportwissenschaftliche Forschung wurde lange vor allem an jungen, männlichen Testpersonen gemacht. Eine Auswertung von Cowley et al. (2021) fand in sportwissenschaftlichen Studien nur 34 % weibliche Teilnehmer, und nur 6 % der Studien untersuchten ausschließlich Frauen. Frauen, Menschen über 50 und Anfänger ohne Trainingserfahrung sind deshalb unterrepräsentiert. Das liegt weniger an böser Absicht der Forscher und Forscherinnen als daran, dass sich die klassische Leistungssportforschung auf andere Gruppen konzentriert hat.
Dazu kommt, dass nicht alle Studien frei zugänglich sind. Artikel hinter Bezahlschranken sind in den Trainingsdaten vermutlich schlechter vertreten als frei zugängliche. Was ein Modell über Sportwissenschaft weiß, hängt also auch davon ab, welche Studien frei im Netz standen, und frei zugängliche Veröffentlichungen sind in der Sportwissenschaft noch nicht selbstverständlich.
Bücher und Fachliteratur
Bücher sind oft die zuverlässigste Quelle, sofern sie digitalisiert und in den Trainingsdaten gelandet sind. Klassiker wie „Science and Practice of Strength Training“ (Zatsiorsky & Kraemer) oder „Periodization“ (Bompa & Haff) dürften ihren Weg in die Trainingsdaten großer LLMs gefunden haben, belegen kann ich das nicht. Ihr Einfluss bei Kraftsport-Themen dürfte spürbar sein.
Der Nachteil: Bücher haben ein Erscheinungsdatum. Ältere Standardwerke können Konzepte enthalten, die neuere Forschung überholt hat. Das LLM merkt das nicht, es gewichtet Texte nach Mustern und nicht nach Aktualität.
Quelle | Anteil (grobe Spanne)* | Stärke | Schwäche |
|---|
Webseiten / Blogs (Common Crawl) | etwa 30 bis über 80 % | Breite Themenabdeckung, aktuelle Diskussionen | Qualität unkontrolliert, Kopier-Kaskaden, Trainingsmythen ranken oft genauso gut wie seriöse Quellen |
Wissenschaftliche Studien (PubMed, arXiv) | etwa 2 bis gut 25 % | Methodisch strukturiert, peer-reviewed | Schieflage Richtung jung und männlich, Bezahlschranken, Sportwissenschaft vermutlich unter 1 % des Gesamten |
Bücher / Fachliteratur | unter 1 bis etwa 15 % | Höchste Qualität, strukturiertes Wissen | Nur digitalisierte Werke, möglicherweise veraltet, neuere Revisionen fehlen |
* Grobe Spannen aus öffentlich dokumentierten Trainingsdatensätzen wie The Pile, Dolma oder C4 und aus Angaben zu frühen LLaMA-Modellen. Die Anteile schwanken je nach Datensatz stark, und die großen Anbieter legen ihre Zusammensetzung nicht offen.
Kurz zusammengefasst: Webseiten und Blogs liefern die größte Menge, aber schwankende Qualität, Kopier-Kaskaden und gut rankende Mythen. Studien sind methodisch sauberer, haben aber eine Schieflage Richtung junge Männer und Bezahlschranken. Bücher sind am zuverlässigsten, aber oft älter. Und alles nach dem Knowledge Cutoff fehlt, es sei denn, du gibst es selbst als Kontext mit.
Welches Modell weiß was: der Vergleich (Stand Oktober 2026)
Nicht alle LLMs haben dieselben Quellen, und das ist für Fitness-Fragen relevant. Wissensstand, Datenbasis und Websuche entscheiden mit, welche Antwortqualität du realistisch erwarten kannst.
Momentaufnahme: Stand Oktober 2026
Modellversionen und Wissensstände ändern sich schnell, die Tabelle zeigt den Stand Oktober 2026. Wenn du das liest, kann sie schon überholt sein. Den aktuellen Stand findest du direkt beim Anbieter: OpenAI, Anthropic, Google. Die Prinzipien dahinter, also Quellenverteilung, Lücken in den Daten und Knowledge Cutoff, bleiben unabhängig von Versionsnummern gleich.
Anbieter | Aktuelles Modell | Verlässlicher Wissensstand | Was über die Daten bekannt ist |
|---|
OpenAI | GPT-6 Astra (Vorgänger GPT-5.6: Februar 2026) | April 2026 | Öffentliches Web, lizenzierte Daten, Nutzerdaten je nach Einstellung |
Anthropic | Claude Opus 5.5, Sonnet 5.5 | Juni 2026 | Öffentliches Web, Daten Dritter, Nutzerdaten mit Einwilligung |
Google | Gemini 4 Argon (Gemini 3 Pro wurde im März 2026 abgeschaltet) | beim Anbieter prüfen | Nicht vollständig offengelegt |
xAI | Grok 4.7 | Mai 2026 | Nicht vollständig offengelegt |
Meta | Llama 4 | August 2024 | Web plus öffentliche Facebook- und Instagram-Beiträge |
Perplexity | nutzt verschiedene Basismodelle | je nach Basismodell | Live-Suche mit Quellenangaben gleicht den Wissensstand teilweise aus |
Für Fitness-Fragen heißt das: Ein Modell mit Wissensstand 2026 kennt Studien aus 2025, Llama 4 mit Stand August 2024 nicht. Bei schnell wachsenden Themen wie Sporternährung macht das einen Unterschied. Meine Vermutung: Modelle, die stark mit Social-Media-Beiträgen trainiert wurden, übernehmen eher Trend-Themen und Mythen, die dort schnell kursieren. Getestet habe ich das nicht.
Faustregel: Für die Grundlagen der Trainingsplanung reichen die aktuellen Flaggschiffe der großen Anbieter. Wie sich die Modelle bei echten Fitnessfragen im direkten Test schlagen, zeigt mein KI-Fitness-Benchmark. Für zeitkritische Fragen zu neuer Forschung, etwa zu Supplementen oder Sporternährung: Perplexity oder ein Modell mit Websuche. Wer Claude strukturiert einsetzen will, findet einen fertigen Startpunkt im Claude Training & Fitness Skill, für Gemini gibt es den Gemini Fitness Coach als Gem.
Lücken in den Daten: wer fehlt
Sportwissenschaftliche Studien haben ein Standardproblem: Nach meinem Eindruck aus der Literatur testen sie vor allem junge Männer, oft Sportstudenten. Frauen, Menschen über 50, Anfänger und Menschen mit Vorerkrankungen sind unterrepräsentiert.
Für ein LLM heißt das: Empfehlungen zu Krafttraining für Frauen in den Wechseljahren stehen auf einem deutlich schmaleren Fundament als Empfehlungen für junge Männer. Das Problem stammt aus der Sportwissenschaft und spiegelt sich im LLM. Das Modell hat gelesen, was veröffentlicht wurde, und veröffentlicht wurde vor allem Forschung an einer bestimmten Gruppe.
Meine Lesart für die Praxis: Wenn du als 54-jährige Frau, die seit 8 Monaten trainiert, einen Prompt ohne diesen Kontext stellst, landest du wahrscheinlich bei der Empfehlung für den Standard-Nutzer, also den 28-jährigen Mann mit 2 Jahren Trainingserfahrung. Böse Absicht steckt da nicht dahinter, es ist schlicht die Verteilung in den Daten.
Das heißt nicht, dass ein LLM für diese Gruppen nutzlos ist. Du musst beim Prompten aber mehr Kontext liefern und die Antworten kritischer einordnen. Dazu gehört auch, gezielt nach den Grenzen zu fragen: „Welche Teile dieser Empfehlung könnten für meine Situation weniger gut passen?“
Lücken je Sportart und der Knowledge Cutoff
Marathon und Radfahren sind im deutsch- und englischsprachigen Web gut dokumentiert, Powerlifting und Gewichtheben ebenfalls. Bei Klettern, Kampfsport oder Rudern wird die Datenbasis schon dünner, und bei echten Nischendisziplinen ist das Wissen eines LLMs oft lückenhaft.
Das liegt schlicht daran, dass weniger Text darüber existiert. Ein LLM kann nur aus dem lernen, was veröffentlicht wurde, und um Nischensportarten gibt es eine kleinere Community, die darüber schreibt.
Knowledge Cutoff beachten
Jedes LLM hat einen festen Wissensstand. Was danach passiert ist, fehlt, egal wie selbstbewusst die Antwort klingt. Welches Datum das für dein Modell ist, ändert sich mit jeder neuen Version. Frag dafür lieber nicht das Modell selbst, denn Modelle geben ihren eigenen Wissensstand oft falsch an. Verlässlicher ist die Angabe beim Anbieter.
Neue Trainingsmethoden haben es besonders schwer. Eine Methode braucht Zeit, bis im Web genug darüber steht, und dann weitere Zeit, bis sie in die Trainingsdaten eines Modells kommt. Was in den letzten Monaten vor dem Wissensstand erschienen ist, kennen die meisten Modelle kaum oder gar nicht.
Das gilt auch für Ansätze, die sich in der Community schnell verbreitet haben. Was viral ging, aber vorher kaum veröffentlicht war, kann im Wissen eines LLMs fehlen oder falsch dargestellt sein, auch wenn jeder in deiner Trainingsgruppe es kennt.
So nutzt du das beim Prompten
Wer weiß, woher das Wissen eines LLMs kommt, kann gezielter fragen und weiß, wann Skepsis angebracht ist.
Du kannst einer KI nur dann die richtigen Fragen stellen, wenn du die Antworten einordnen kannst.
Je mehr du über Training weißt, desto besser kannst du die Schwächen des LLMs ausgleichen. Du erkennst, wenn eine Antwort zu allgemein ist. Du weißt, welche Empfehlungen zu deiner Situation passen müssen. Und du kannst das LLM gezielt auf fehlende Informationen hinweisen oder eigene Quellen mitgeben.
Wenn du zu einer Gruppe gehörst, die in den Daten unterrepräsentiert ist, sag das ausdrücklich im Prompt. Alter, Geschlecht, Trainingserfahrung, Ziel: Dieser Kontext macht den Unterschied. Ohne ihn bekommst du eher die Standard-Empfehlung für den Standard-Nutzer.
Das gilt genauso für den Wissensstand. Wenn dein Thema neuere Entwicklungen betrifft, sag das direkt im Prompt, zum Beispiel so:
Prompt
Dein Wissensstand reicht nur bis zu einem bestimmten Datum. Falls du neuere Entwicklungen zu diesem Thema nicht kennst, sag das ausdrücklich. Ich arbeite dann mit einer Primärquelle weiter. Berücksichtige außerdem, dass sportwissenschaftliche Studien eine bekannte Schieflage Richtung junge, männliche Testpersonen haben. Mein Profil: [Alter, Geschlecht, Trainingserfahrung, Ziel, Sportart].
Wenn du eine Nischensportart betreibst oder mit einer neueren Methode arbeitest, gib dem LLM die wichtigsten Grundlagen mit: Auszüge aus Studien oder eine kurze Erklärung des Ansatzes. Das gleicht die Wissenslücke für dieses Gespräch aus. Dauerhaft lernt das Modell daraus nicht, in diesem Gespräch kann es aber damit arbeiten.
Der direkteste Weg um den Knowledge Cutoff herum ist die Websuche. Wenn das Modell aktuelle Inhalte abrufen kann, gleicht das den eingefrorenen Wissensstand zumindest teilweise aus. Wie gut das klappt, hängt vom Tool ab und davon, ob die Suche überhaupt läuft.
Tool | Web Search | Aktivierung | Hinweis |
|---|
Perplexity | Ja, Kernfunktion | Immer aktiv | Web Search ist das Hauptprodukt, keine Umstellung nötig |
Gemini | Ja, über Google | Automatisch | Direkte Anbindung an die Google-Suche, standardmäßig aktiv |
ChatGPT | Ja | Automatisch (Free & Plus) | Wird bei relevanten Prompts selbstständig genutzt |
Claude | Ja | Automatisch in der aktuellen App | Sucht in der aktuellen Oberfläche selbstständig, in älteren Oberflächen per Schalter |
Stand Oktober 2026, kann sich ändern
Funktionen wie die Websuche passen die Anbieter laufend an. Was heute automatisch läuft, kann morgen hinter einem Schalter verschwinden oder umgekehrt. Die Tabelle zeigt den Stand der letzten Prüfung im Oktober 2026. Im Zweifel schau in die Hilfe-Seiten des Anbieters.
Die Websuche löst das Cutoff-Problem, schafft aber sofort ein neues. Das Modell sucht im selben Web, das ich weiter oben als problematisch beschrieben habe: Blogs ohne Fachkenntnis, Kopier-Kaskaden, gut rankende Mythen. Wenn ChatGPT mit Websuche nach „bestes Krafttraining für Frauen über 50“ sucht und die ersten drei Treffer Ratgeberseiten ohne sportwissenschaftlichen Hintergrund sind, landet genau dieses Halbwissen in deiner Antwort, frisch und gut verpackt.
Schlechte Quellen rein, schlechte Antwort raus, auch mit Websuche.
Die Websuche ist trotzdem sinnvoll, vor allem wenn du weißt, wonach du suchst. Wer dem Modell konkrete Quellen nennt, bekommt nach meiner Erfahrung bessere Ergebnisse, als wer es frei suchen lässt. Das kannst du direkt im Prompt steuern:
Prompt
Suche ausschließlich in PubMed (pubmed.ncbi.nlm.nih.gov) nach peer-reviewed Studien zu [Thema]. Gib mir Titel, Jahr und DOI, kein freies Surfen im Web.
Die Auswahl der Quellen liegt also bei dir.
Wissen haben heißt nicht Wissen richtig anwenden
Selbst wenn ein LLM eine Studie kennt, wendet es sie nicht unbedingt richtig an. Es kann dir mit voller Überzeugung eine Metaanalyse nennen und dabei Autor, Jahr oder Kernaussage verdrehen. Einen eingebauten Hinweis auf Unsicherheit gibt es nicht. Das Modell klingt bei einer richtigen Antwort genauso sicher wie bei einer falschen.
Das ist ein eigenes Thema, das über die Frage nach den Quellen hinausgeht. Wo das konkret passiert, mit Beispielen aus dem Fitnessbereich und woran du es erkennst, zeigt Wo KI-Trainingspläne scheitern.
Fazit: Das LLM weiß, was im Text steht
Das Wissen eines LLMs über Training ist nicht gleichmäßig verteilt. Es spiegelt, was veröffentlicht wurde, mit allen Schwerpunkten, Schieflagen und Lücken. Dazu kommt, dass das Modell vorhandenes Wissen nicht immer richtig anwendet. Wer das versteht, kann das Werkzeug sinnvoll einsetzen und einen passenden Trainingsplan mit KI erstellen. Wer das ignoriert, bekommt Standardantworten für Standardsituationen, formuliert mit der Selbstsicherheit eines Olympia-Trainers.
Das LLM weiß, was im Text steht. Was in keinem Text steht, weiß es nicht. Die Lücken zu kennen und selbst zu füllen, liegt bei dir.