Du schaust morgens auf deine Uhr, siehst eine niedrige HRV und fragst dich: leichter Tag oder durchziehen? Eine neue Studie aus China setzt eine Ebene höher an. Ein System lernt durch Ausprobieren, Woche für Woche zwischen mehr Intensität, mehr Umfang und aktiver Erholung zu wählen. Bisher allerdings nur in der Simulation.
Gelernt hat es an einem digitalen Zwilling, also an einem Rechenmodell, das aus den Daten von 25 Leichtathleten vorhersagt, wie der Körper auf eine Trainingswoche reagiert.
Auf einen Blick
Forscher der AnYang Normal University haben einen Agenten gebaut, der durch Versuch und Irrtum lernt, die Trainingsbelastung zu steuern. Geübt hat er an einem Simulationsmodell aus 24 Wochen Daten von 25 Leichtathleten: HRV, Schlafscore, Belastung aus RPE mal Dauer und ein wöchentlicher 400-m-Test. Punkte gibt es für bessere 400-m-Zeiten und für gute Erholungswerte. In der Simulation wurde die Leistung besser, und der Belastungsquotient ACWR blieb in jeder Woche unter der Gefahrenschwelle von 1,5. An echten Athleten getestet wurde das noch nicht.
Immer auf dem Laufenden zu KI-Training & Analyse? Ein Klick – und du bekommst meine Artikel bei Google bevorzugt angezeigt.
Das Problem: Zwei Trainingsstrategien lassen sich nicht gleichzeitig an derselben Person testen
Wer wissen will, welche Belastungsstrategie besser funktioniert, stößt schnell an eine Grenze: Du kannst nicht zwei Ansätze gleichzeitig fahren. In der Gruppe geht das, Gruppe A trainiert so, Gruppe B anders. Dann weißt du aber nur, was im Schnitt funktioniert.
Was für den Durchschnitt gilt, sagt wenig darüber, wie du persönlich auf mehr Einheiten oder mehr Umfang reagierst.
Qi Zhang, Qing Wang und Yonggang Niu von der AnYang Normal University (China) gehen das anders an. Ihre Studie heißt „Adaptive training load optimization for track and field athletes: A reinforcement learning approach“. Grundlage sind Daten von 25 Leichtathleten (12 Männer, 13 Frauen) aus einer Saison von 24 Wochen, insgesamt 4.200 Tageswerte. Daraus haben sie ein Modell gebaut, das vorhersagt, wie sich eine Trainingsentscheidung auf HRV, Schlaf und Leistung auswirkt.
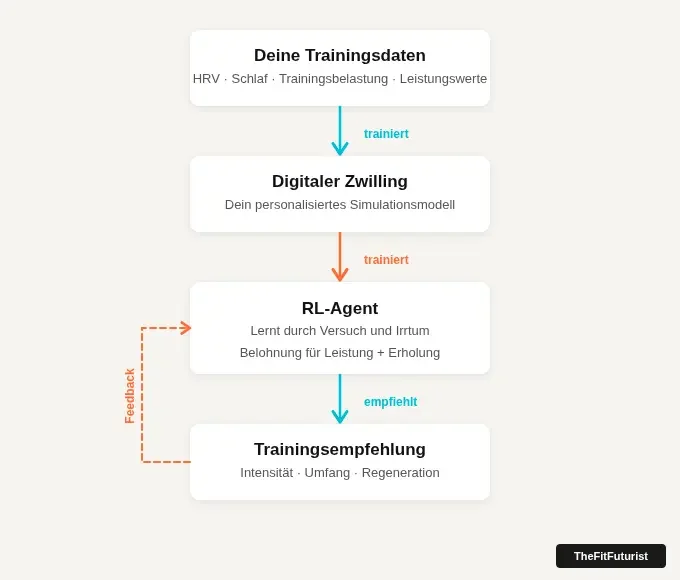
Die Forscher nennen das einen „digitalen Zwilling“. Ich habe nachgeschaut, wie persönlich der ist: Es ist ein gemeinsames Modell (ein Random Forest) aus den Daten aller 25 Athleten. Persönlich wird es nur dadurch, dass jeder Wert an der eigenen Norm des Athleten gemessen wird, etwa deine HRV im Vergleich zu deinem üblichen Wert. Ein eigenes Modell pro Person ist das nicht. An diesem Modell kann der Agent beliebig viele Strategien ausprobieren, ohne dass jemand dafür eine Saison trainieren muss.
So funktioniert das System: Aus den Athletendaten entsteht ein Simulationsmodell, an dem der RL-Agent lernt und Empfehlungen ausgibt.
Wie das System entscheidet: Belohnung für gute Entscheidungen, Strafe für schlechte
Das Prinzip heißt Reinforcement Learning, auf Deutsch bestärkendes Lernen. Der Agent schaut sich den aktuellen Zustand an, wählt eine von drei Optionen (Intensität erhöhen, Umfang erhöhen oder aktiv regenerieren) und bekommt dafür Punkte oder Abzug.
Trainiert wurde über 500 simulierte Durchläufe. Der Agent sieht dabei sechs Werte: HRV (RMSSD in den ersten 5 Minuten nach dem Aufwachen), einen Schlafscore der Smartwatch von 0 bis 100, die Belastung der letzten 7 und der letzten 28 Tage, das Verhältnis der beiden (ACWR) und die Zeit aus einem 400-m-Test am Ende jeder Woche.
HRV und Schlaf liefert deine Uhr. Die Belastung kam in der Studie aus dem Anstrengungsempfinden mal Trainingsdauer (sRPE), die Leistung aus einem festen 400-m-Test jede Woche. Beides müsstest du selbst erfassen. Machbar ist das trotzdem, Labordiagnostik braucht es dafür keine.
Die Belohnung: Punkte für Leistung und für Erholung
Am spannendsten finde ich die Belohnung. Belohnst du einen Agenten nur für Leistung, überzieht er. Das zeigen die Autoren selbst: In einer Variante, die nur für bessere 400-m-Zeiten Punkte bekam, landete der simulierte Athlet ab Woche 9 in der Gefahrenzone.
Deshalb gibt es zwei Belohnungen. Eine für schnellere 400-m-Zeiten, eine für den Erholungszustand: Steigen HRV und Schlafscore, gibt es Punkte. Liegt der ACWR zwischen 0,8 und 1,3, gibt es einen kleinen Bonus. Ab 1,5 gilt die Belastung als Gefahrenzone, dann gibt es deutlich Abzug.
In der Simulation ging die Rechnung auf. Die 400-m-Zeit wurde besser, ausgehend von im Schnitt etwa 65 Sekunden, und der Agent hat den ACWR in keiner Woche über 1,5 getrieben. Wichtig: Das „Verletzungsrisiko“ im Paper ist dieser ACWR-Wert. Verletzungen wurden nicht gezählt. Ob das an echten Menschen genauso funktioniert, ist offen.
Was das Ganze noch nicht ist
Getestet wurde nur im Simulationsmodell, an keinem echten Athleten. Die Autoren nennen es selbst einen Proof of Concept. Der Agent hat gelernt, im Modell gut abzuschneiden. Ob er echte Trainingsentscheidungen besser macht, zeigt die Studie nicht.
Die Autoren nennen auch selbst Grenzen. Das Modell tut so, als reagiere der Körper immer gleich und als sei alles Wichtige messbar. Stress, Hormone und Zufall fehlen. Ermüdung, die sich über Wochen aufbaut, bildet es nicht ab, weil es nur den aktuellen Zustand sieht. Und es gibt nur drei grobe Optionen, keine Übungswahl, keine Pausenlängen, keine bestimmten Erholungsmethoden.
25 Athleten, eine Saison, eine Sportart, eine Universität: Das reicht, um ein Konzept zu zeigen. Ein fertiger KI-Coach ist das noch nicht.
Zur Übertragung auf andere Sportarten: Das Prinzip aus Simulationsmodell, bestärkendem Lernen und doppelter Belohnung ist nicht an die Leichtathletik gebunden. Praktisch heißt das aber neue Daten, eine neue Saison und ein neues Modell für die jeweilige Sportart.
Meine Vermutung zum Kraftsport: Dort ist HRV als Steuerungswert weniger erprobt als im Ausdauerbereich. Das Modell müsste dafür komplett neu trainiert werden.
Meine Einschätzung
Mich interessiert an der Arbeit weniger das Ergebnis als der Ansatz. Das Simulationsmodell löst ein echtes Problem: Du kannst zwei Strategien nicht gleichzeitig an derselben Person testen. Im Modell geht das, beliebig oft und ohne eine echte Saison abzuwarten.
Für dein Training heute ändert die Studie nichts. Meine Lesart: Sie zeigt eine mögliche Richtung, weg von festen Regeln wie „HRV niedrig, also leichter Tag“ hin zu einem System, das aus Daten lernt. Ob das besser funktioniert als die Regeln, muss erst ein Test mit echten Athleten zeigen.
Die vollständige Studie ist in Scientific Reports erschienen: Zhang, Wang und Niu (2026), „Adaptive training load optimization for track and field athletes: A reinforcement learning approach“, Sci Rep 16, 14862 (DOI: 10.1038/s41598-026-41946-w).